

Dalam arsitektur cloud modern, resilience menjadi salah satu indikator utama kualitas sistem. Resilience bukan hanya kemampuan sistem untuk bertahan dari gangguan, tetapi juga kemampuan untuk pulih secara cepat tanpa mengganggu pengalaman pengguna. Pada platform slot berbasis cloud, konsep ini menjadi krusial karena sistem harus tetap stabil di tengah beban tinggi, lonjakan traffic, dan potensi kegagalan komponen.
Oleh karena itu, strategi meningkatkan resilience pada slot berbasis cloud berfokus pada desain sistem yang adaptif, fault-tolerant, dan mampu melakukan recovery secara otomatis.
Memahami Konsep Resilience dalam Cloud
Resilience adalah kemampuan sistem untuk tetap berfungsi meskipun terjadi gangguan pada sebagian komponennya. Dalam konteks cloud native, resilience mencakup:
- Fault tolerance
- Self healing system
- Redundancy
- Graceful degradation
- Automatic recovery
Dengan pendekatan ini, sistem tidak hanya dirancang untuk bekerja dalam kondisi ideal, tetapi juga dalam kondisi ekstrem.
Mengapa Resilience Penting pada Platform Cloud
Platform digital modern berjalan dalam lingkungan yang dinamis. Gangguan bisa terjadi kapan saja, mulai dari masalah jaringan hingga kegagalan service.
Manfaat utama resilience:
- Mengurangi downtime sistem
- Meningkatkan availability
- Menjaga pengalaman pengguna tetap stabil
- Mengurangi dampak kegagalan sistem
- Meningkatkan kepercayaan operasional
Dalam istilah enterprise, resilience adalah “operational insurance” untuk menjaga kontinuitas layanan.
Pilar Utama Resilience Cloud
1. Fault Tolerance
Fault tolerance adalah kemampuan sistem untuk tetap berjalan meskipun sebagian komponen gagal.
Strateginya meliputi:
- Redundansi server
- Failover system
- Multi-zone deployment
2. High Availability
High availability memastikan sistem selalu dapat diakses dengan downtime minimal.
Biasanya dicapai dengan:
- Load balancing
- Clustered architecture
- Distributed infrastructure
3. Scalability
Scalability memungkinkan sistem menyesuaikan kapasitas sesuai beban.
- Horizontal scaling untuk traffic tinggi
- Auto scaling berbasis metrik real time
4. Self Healing
Self healing memungkinkan sistem memperbaiki dirinya sendiri secara otomatis tanpa intervensi manual.
Contoh:
- Restart service otomatis
- Re-routing traffic
- Auto recovery node failure
Strategi Meningkatkan Resilience pada Slot Berbasis Cloud
1. Implementasi Multi Region Architecture
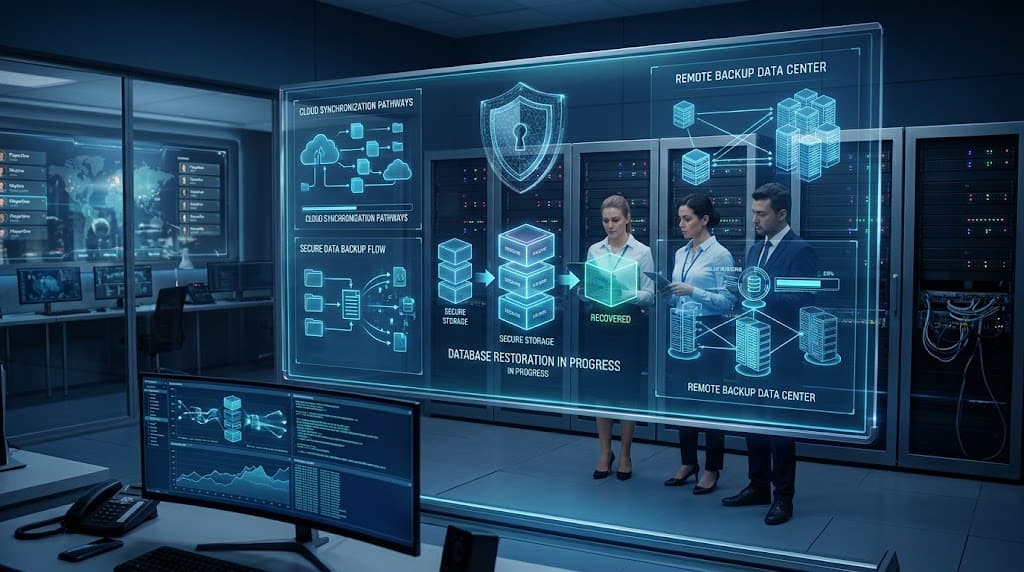
Menyebarkan sistem ke beberapa wilayah geografis meningkatkan ketahanan terhadap kegagalan lokal.
Jika satu region gagal, traffic dapat dialihkan ke region lain.
2. Load Balancing Adaptif
Load balancer mendistribusikan traffic secara merata ke beberapa server.
Strategi modern meliputi:
- Dynamic load balancing
- Latency-based routing
- Health check routing
3. Circuit Breaker Pattern
Circuit breaker mencegah kegagalan berantai dalam sistem terdistribusi.
Jika satu service gagal, request akan dihentikan sementara untuk mencegah overload.
4. Retry dan Timeout Strategy
Sistem harus memiliki mekanisme retry yang terkontrol.
Namun harus disertai:
- Exponential backoff
- Timeout policy yang jelas
- Limit retry agar tidak overload
5. Event-Driven Architecture
Arsitektur berbasis event meningkatkan resilience karena:
- Sistem tidak saling bergantung secara langsung
- Proses asynchronous mengurangi blocking
- Event queue membantu buffering beban
6. Observability dan Monitoring
Resilience tidak bisa dipisahkan dari observability.
Komponen penting:
- Metrics real time
- Distributed tracing
- Centralized logging
- Alerting system
Prinsip ini membantu sistem memahami stabilitas jangka panjang berdasarkan kumpulan data besar, sehingga anomali dapat dideteksi lebih akurat dalam skala produksi.
7. Chaos Engineering
Chaos engineering adalah pendekatan untuk menguji ketahanan sistem dengan cara mensimulasikan kegagalan.
Contoh pengujian:
- Mematikan node secara acak
- Menurunkan bandwidth jaringan
- Mengganggu service tertentu
Tujuannya adalah memastikan sistem tetap stabil dalam kondisi tidak ideal.
Tantangan dalam Meningkatkan Resilience
Kompleksitas Infrastruktur
Semakin banyak service, semakin sulit menjaga konsistensi resilience.
Biaya Operasional
Redundansi dan multi region meningkatkan biaya cloud.
Latency Tambahan
Failover dan routing adaptif dapat menambah delay kecil.
Debugging Sulit
Sistem yang terlalu terdistribusi sulit dianalisis saat terjadi error.
Best Practice Resilience Cloud
- Gunakan desain stateless service
- Terapkan autoscaling berbasis metrik
- Gunakan distributed cache
- Implementasikan graceful degradation
- Gunakan observability sebagai fondasi utama
Masa Depan Resilience Cloud
Resilience akan berkembang menuju AI-driven self healing system. Sistem masa depan tidak hanya merespons kegagalan, tetapi juga memprediksi dan mencegahnya sebelum terjadi.
Dengan integrasi machine learning, cloud system akan menjadi lebih adaptif, otomatis, dan proaktif.
Kesimpulan
Strategi meningkatkan resilience pada slot berbasis cloud berfokus pada kemampuan sistem untuk bertahan dan pulih dari gangguan melalui fault tolerance, high availability, auto scaling, dan observability. Dengan dukungan arsitektur modern seperti event-driven system dan chaos engineering, resilience menjadi fondasi utama untuk menjaga stabilitas platform digital skala besar. Meskipun kompleks dan berbiaya tinggi, pendekatan ini memastikan sistem tetap andal dalam kondisi apa pun.


Leave a Reply